vaiacon vaiaconversation · Handbuch
Zwei Modelle · ein Gespräch · du führst Regie

Lass zwei KIs streiten, bevor du entscheidest.

vaiaconversation setzt zwei Sprachmodelle mit klaren Rollen an einen Tisch: Treuhänder gegen Beraterin, Entwicklerin gegen Prüfer, Opus gegen GPT. Du gibst das Thema, hörst zu, wirfst ein, lässt ein drittes Modell urteilen – und bekommst am Ende ein Protokoll mit Zeit und Kosten je Beitrag.

Gerät öffnen
Was das Gerät bringt

Ein Modell antwortet. Zwei Modelle prüfen sich.

Eine einzelne KI gibt dir die erste plausible Antwort und bleibt dabei. Zwei Modelle mit gegensätzlichen Rollen müssen Einwände aushalten, Beispiele liefern und nachbessern. Das ist dasselbe, was in einem guten Meeting passiert – nur in zwei Minuten, protokolliert, und ohne dass jemand das Gesicht wahren muss.

01 · Rollen

Haltung statt Höflichkeit

Jeder Sprecher bekommt eine Rolle mit Haltung: «vorsichtiger Treuhänder», «Reviewer, der Randfälle sucht». Die Rolle gilt das ganze Gespräch, nicht nur für eine Antwort.

02 · Regie

Du bist nicht Gegenüber, du bist Moderator

Pause, Schritt für Schritt, Einwurf mitten im Gespräch, weitere Runden anhängen, Fazit durch ein drittes Modell. Du steuerst, ohne selbst tippen zu müssen.

03 · Anbieter-Mix

Claude, GPT, Gemini, lokal

Claude über die Claude Code CLI, GPT über Codex, Gemini über Antigravity, Qwen und Co. lokal über Ollama. Verschiedene Hersteller haben verschiedene blinde Flecken – genau deshalb lohnt sich der Mix.

04 · Agenten

Reden oder arbeiten

Backend «claude» redet nur. Backend «agent» ist Claude Code mit Werkzeugen: liest und schreibt Dateien, führt Tests aus – eingesperrt in einen Arbeitsordner, mit vier Freiheitsstufen.

05 · Kontrolle

Erlaubnis-Karte und Werkstatt

Will ein Agent etwas ausserhalb der Whitelist, erscheint eine orange Karte: erlauben, fürs Gespräch merken, ablehnen mit Begründung. Die Werkstatt zeigt live, welche Dateien entstehen.

06 · Protokoll

Markdown, Zeit, Kosten

Jedes Gespräch landet als Markdown-Datei mit Kopfzeile: Modelle, Tempo, Runden. Unter jedem Beitrag stehen Sekunden und Kosten. Was es gebracht hat, ist nachlesbar und teilbar.

Einordnung

Gegenüber dem Claude-Code-Harness

Claude Code ist ein Agent, der für dich arbeitet: du fragst, er antwortet und handelt. vaiaconversation nutzt denselben Agenten als Baustein, stellt ihm aber ein zweites Modell gegenüber und dich darüber. Beides ergänzt sich – das eine erledigt, das andere prüft und entscheidet.

Claude Code (Harness)vaiaconversation
GesprächsformMensch ↔ ein AgentModell ↔ Modell, Mensch als Regie
Zweite Meinungmusst du selbst einholen (neue Sitzung, anderes Werkzeug)eingebaut: Rolle B widerspricht ab dem ersten Satz
AnbieterClaudeClaude, GPT (Codex), Gemini (Antigravity), lokale Modelle (Ollama) – im selben Gespräch mischbar
RollenSystem-Prompt pro Sitzung, meist implizitzwei explizite Rollen mit Vorlagen (Streitgespräch, Interview, Brainstorm, Lehrer & Schüler, Pair Programming)
SteuerungEingabezeile; unterbrechen heisst EscapePause, Schritt, Einwurf, «Noch N Runden», Fazit – ohne den Faden zu verlieren
Werkzeugealle, nach Permission-Modevier Freiheitsstufen je Gespräch; Erlaubnis-Karte im Browser statt Terminal-Prompt
Kontext-Lastlädt alle MCP-Server und globalen Einstellungenbewusst ohne MCP, ohne globale Einstellungen – Opus-Zug 3–4 s statt 8–9 s
ErgebnisChatverlauf in der SitzungMarkdown-Protokoll mit Zeit und Kosten je Beitrag, jederzeit fortsetzbar
Urteil–Fazit durch ein drittes Modell: Kernaussagen, einig/uneinig, offene Punkte, Urteil
Vorlesen–zwei Stimmen über say, Gespräch nebenbei hören
Programmieren

Vier Augen, zwei Hersteller, ein Arbeitsordner

Beim Programmieren ist der grösste Fehler nicht der Tippfehler, sondern der Randfall, an den niemand gedacht hat. Ein einzelner Agent übersieht ihn, weil er seinen eigenen Code für richtig hält. Ein zweiter Agent mit der Rolle «Prüfer» hat keinen Grund dazu.

Vorteil 1

Bauer und Prüfer

Vorlage «Pair Programming»: A schreibt Code und Tests, B liest, führt aus und meldet einen konkreten Fehler mit Zeilenangabe. Im Beispiel unten fand der Prüfer nan/inf in der Zahlenprüfung, eine fehlende Datei ohne Fehlermeldung und ein nutzloses Median-Ergebnis bei zwei Positionen – alles in Runde 1.

Vorteil 2

Herstellerwechsel als Prüfmethode

Claude baut, GPT über Codex prüft (Kurzwahl «Claude gegen Codex»). Zwei Trainings, zwei Stile, zwei Arten von blinden Flecken. Was beide durchwinken, ist mit hoher Wahrscheinlichkeit in Ordnung.

Vorteil 3

Tests laufen wirklich

Die Agenten behaupten nicht, dass es funktioniert – sie führen python3 -m unittest aus, und die Werkzeug-Zeile im Beitrag zeigt den Befehl. Im Beispiel: 9 Tests grün, Exit-Code 2 bei fehlender Datei, geprüft.

Vorteil 4

Sandkasten mit Stufen

Werkstatt: nur Arbeitsordner, Bash nur Whitelist. Weit: auch Web, aber keine Dateien ausserhalb. Alles: keine Schranke. Du wählst je Gespräch, was der Code darf – und siehst in der Werkstatt-Leiste, was entsteht.

Vorteil 5

Tempo nach Aufgabe

Schnell (--effort low) für Stilfragen und kleine Skripte, gründlich (--effort high) für Architektur. Die Kurzwahl setzt Modelle, Tempo, Länge und Freiheit in einem Schritt und erklärt, was dabei passiert.

Vorteil 6

Du greifst ein, ohne zu unterbrechen

Einwurf als Moderator: «Nimm die Variante mit Auftragsnummer», und beide Agenten arbeiten mit der Vorgabe weiter. Pause und Schritt, wenn du jeden Zug sehen willst. Das Protokoll hält fest, was warum entschieden wurde.

Beispiele

So sieht das aus

1 · Streitgespräch: Soll ein Sanitärbetrieb Offerten von einer KI vorschreiben lassen?

A · Treuhänder Moser · claude:opusB · Beraterin Keller · claude:haikuTempo schnell2 Runden · 80 Wörter

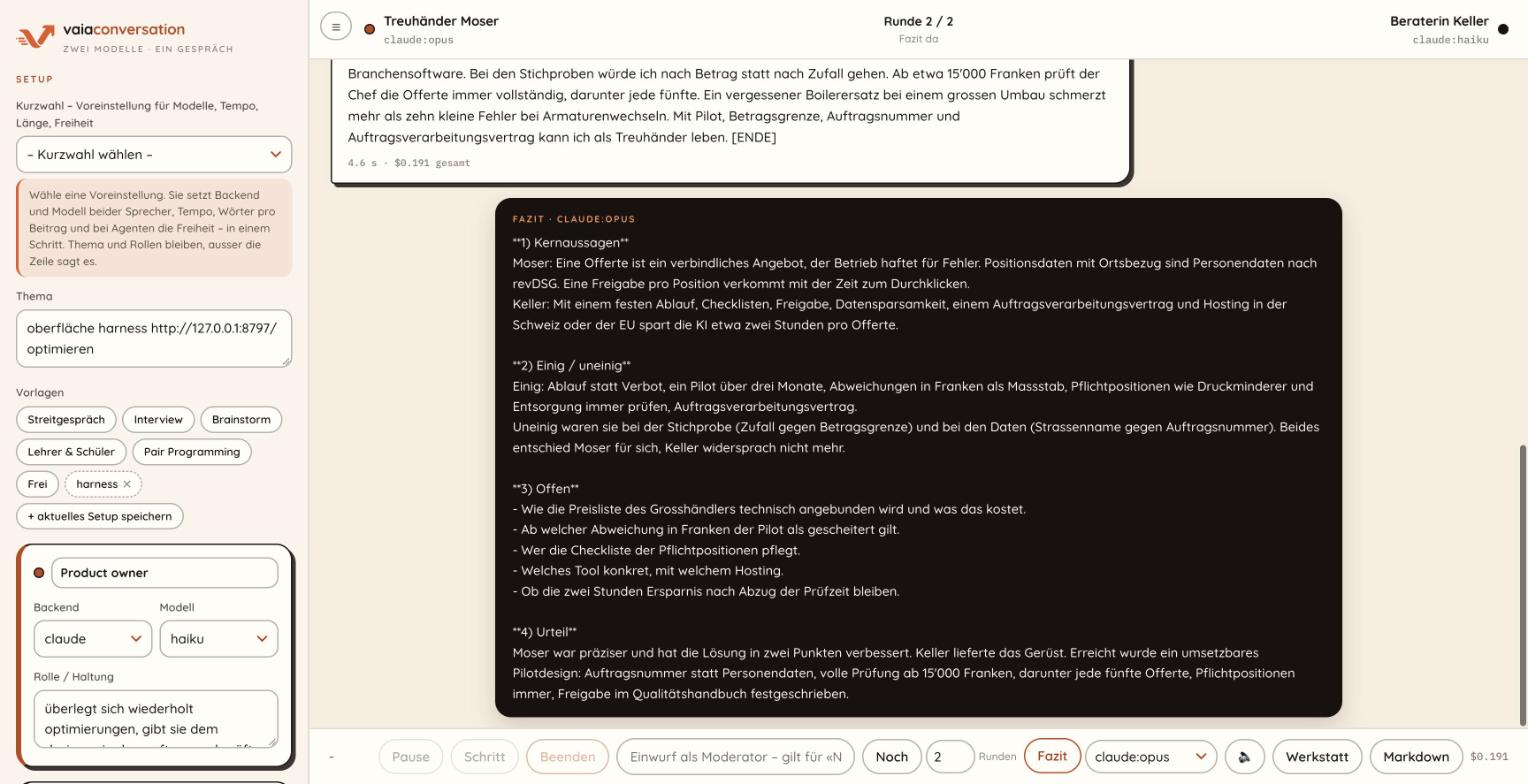
Der Treuhänder sieht Haftung und revDSG, die Beraterin rechnet in gesparten Stunden. Nach vier Beiträgen steht ein umsetzbarer Pilot: Auftragsnummer statt Personendaten, volle Prüfung ab 15'000 Franken, Pflichtpositionen immer prüfen. Gesamt 19 Sekunden, 19 Rappen.
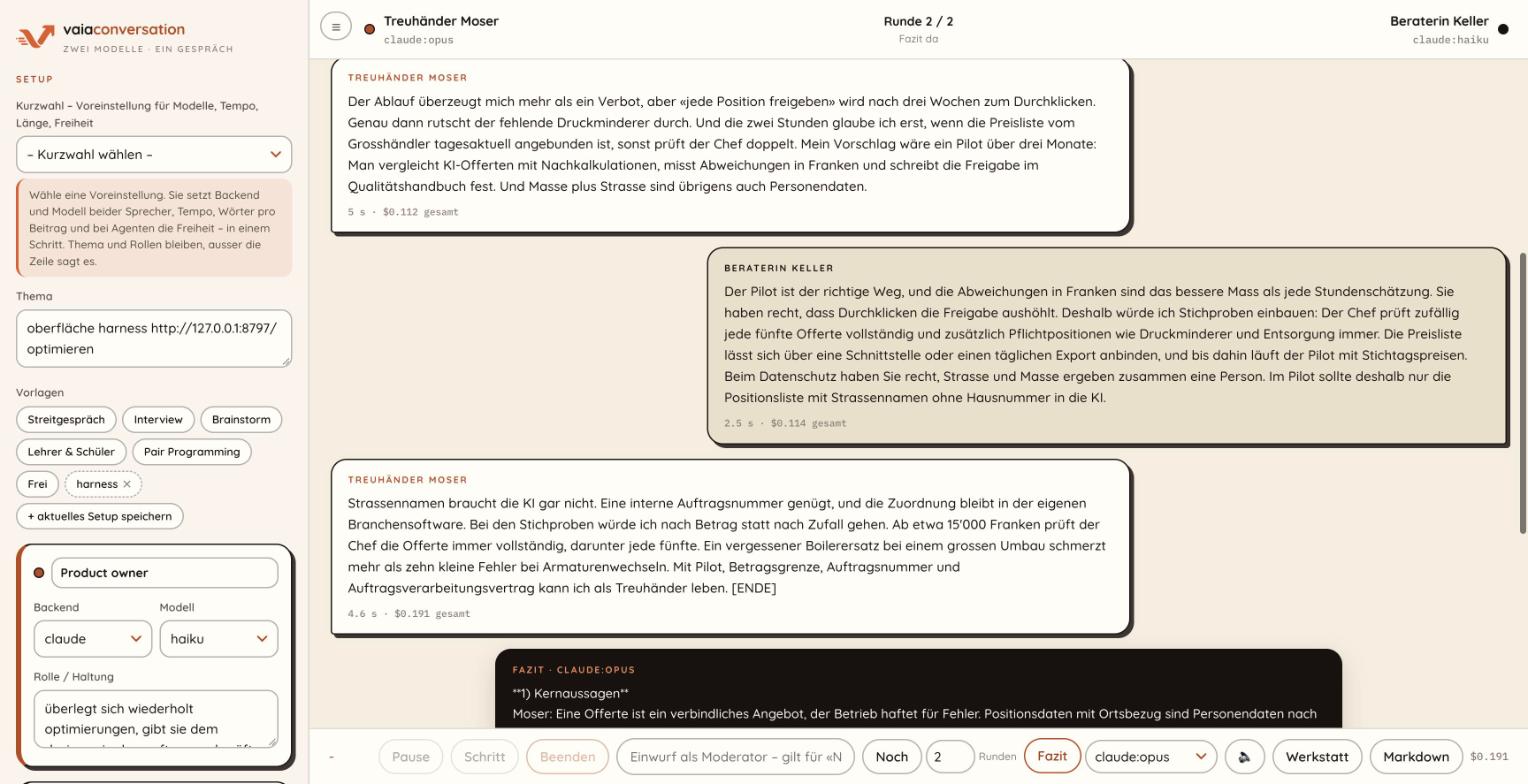
Streitgespräch zwischen Treuhänder und Beraterin
Beiträge mit Zeit und Kosten. Links das Setup mit Kurzwahl, Vorlagen und den beiden Sprecher-Karten; rechts das Gespräch. Unter jedem Beitrag: Sekunden und bisherige Kosten.
Fazit durch ein drittes Modell
Fazit durch ein drittes Modell. Ein Klick auf «Fazit» lässt Opus das Gespräch beurteilen: Kernaussagen, einig/uneinig, offene Punkte, Urteil – wer war präziser, wer hat die Lösung verbessert.

2 · Pair Programming: ein Werkzeug, das Ausreisser in Offertpositionen findet

A · Bauer · agent:sonnetB · Prüfer · agent:haikuFreiheit weit2 Runden

Aufgabe: offerte_check.py liest eine CSV (Bezeichnung;Menge;Einzelpreis) und meldet Positionen, die mehr als 20 % vom Median abweichen. Was passierte:

  • Runde 1, Bauer: Skript, Beispiel-CSV, Testlauf – Median 358, zwei Treffer gemeldet.
  • Runde 1, Prüfer: liest den Code, baut drei Randfall-CSVs, findet float() akzeptiert nan, fehlende Datei endet im Traceback, Median bei zwei Positionen sagt nichts aus. Jeweils mit Zeilenangabe.
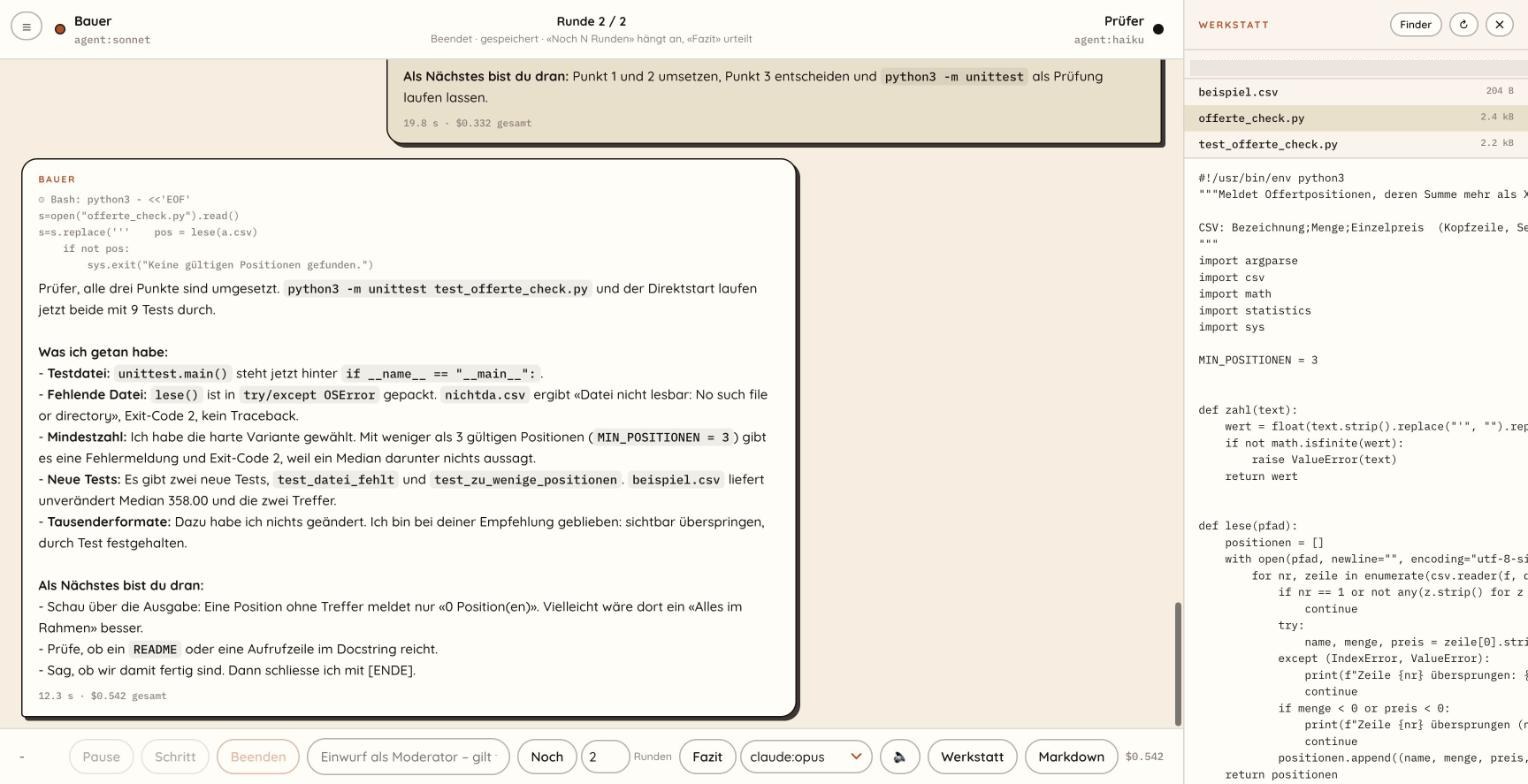
  • Runde 2, Bauer: setzt alles um, schreibt zwei neue Tests, 9 Tests grün. Fragt den Prüfer, ob fertig.

Gesamt rund 70 Sekunden, 54 Rappen. Die drei Dateien liegen im Arbeitsordner und sind sofort brauchbar.

Pair Programming mit offener Werkstatt
Werkstatt rechts, Gespräch in der Mitte, Setup eingeklappt. Die Werkzeug-Zeilen (⚙ Bash) zeigen, was der Agent wirklich ausgeführt hat. Rechts die Dateien im Arbeitsordner, angeklickt: der Code.
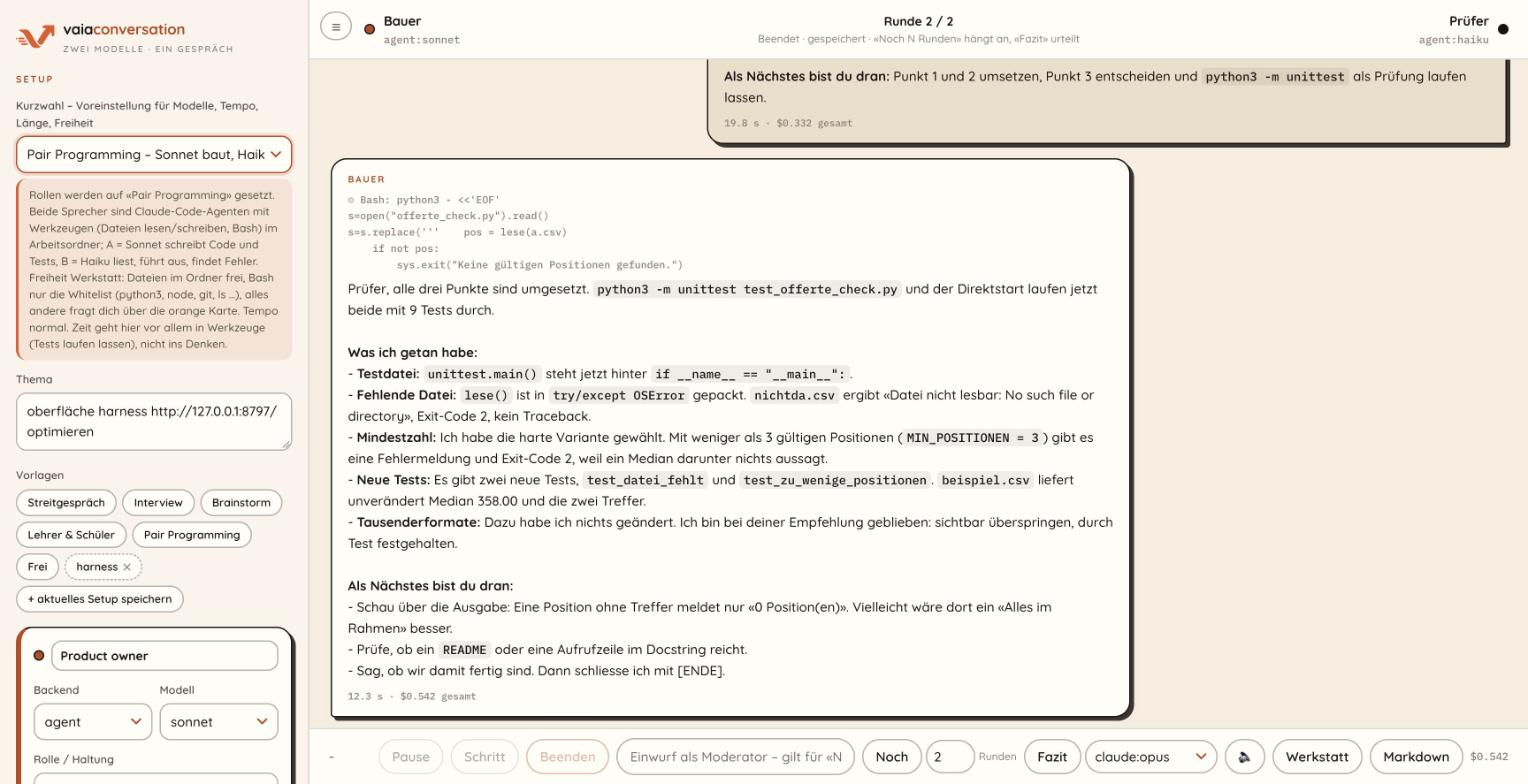
Kurzwahl Pair Programming mit Erklärung
Kurzwahl mit Erklärung. «Pair Programming – Sonnet baut, Haiku prüft» setzt beide Sprecher, Rollen, Freiheit und Tempo. Der Text darunter sagt genau, was passiert: welche Schalter, welche Grenzen, wo die Zeit hingeht.

3 · Die Erlaubnis-Karte

A · Rechercheur · agent:haikuFreiheit werkstatt

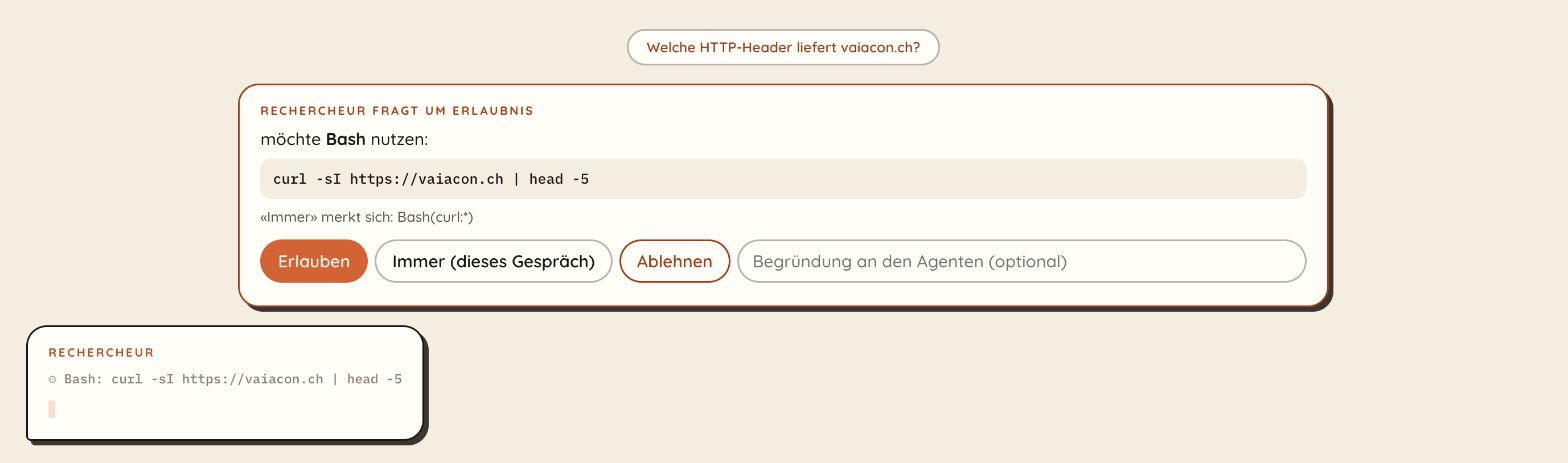
In der Stufe «Werkstatt» darf ein Agent nur Befehle aus der Whitelist. curl gehört nicht dazu – also hält das Gespräch an und fragt dich. «Immer» merkt sich Bash(curl:*) für dieses Gespräch, «Ablehnen» schickt deine Begründung an den Agenten, der dann einen anderen Weg sucht.

Erlaubnis-Karte
Der Agent wartet, bis du klickst. Der Browser-Tab blinkt mit «⚠ Erlaubnis», die Kopfzeile sagt «wartet auf deine Erlaubnis: Bash». Nichts läuft, bevor du entschieden hast.
Bedienung

Drei Schritte bis zum ersten Gespräch

Schritt 1

Kurzwahl

Oben links eine Voreinstellung wählen. «Blitz» für einen Test in 30 Sekunden, «Gründlich – Fable gegen Opus» für eine echte Entscheidung, «Pair Programming» für Code. Der Erklärtext darunter sagt, was die Wahl bewirkt.

Schritt 2

Thema und Rollen

Thema als Frage formulieren. Vorlagen setzen die Rollen; eigene Formulierungen in den beiden Sprecher-Karten. «+ aktuelles Setup speichern» macht daraus einen eigenen Chip.

Schritt 3

Regiepult

Unten: Pause, Schritt, Beenden, Einwurf (Enter) mit Ziel «an beide», «nur A sieht» oder «nur B sieht» – ein vertraulicher Einwurf fehlt im Verlauf des anderen Sprechers und steht im Protokoll als «Moderator (nur A)». Dazu «Noch N Runden», Fazit mit Modellwahl, Vorlesen, Werkstatt, Markdown-Export. Die Zahl ganz rechts sind die Kosten bisher.

Kurzwahlen

KurzwahlSprecherTempo · Länge · FreiheitWofür
BlitzHaiku × 2schnell · 60 WörterFunktionstest, Thema ausprobieren
Schnell und klugOpus × 2schnell · 120Alltag: Meinungen, Texte, Argumente
GründlichFable gegen Opusgründlich · 200Entscheidungen, Konzepte
Pair ProgrammingSonnet baut, Haiku prüft (agent)normal · 150 · Werkstattkleine Werkzeuge, Skripte, Tests
Pair Programming gründlichOpus × 2 (agent)gründlich · 200 · AutoUmbauten, Architektur
Claude gegen CodexOpus gegen GPTschnell · 120Herstellerwechsel als Prüfung
LokalQwen × 2 (Ollama)normal · 100ohne Netz, ohne Kosten, vertrauliche Inhalte
Einrichtung

Läuft in einer Minute

Nur Python 3 und die Claude Code CLI sind Pflicht. Codex, Antigravity und Ollama sind optional und erscheinen automatisch, wenn sie da sind. Details, Freiheitsstufen und Fehlerbilder stehen in ANLEITUNG.md.

cd ~/Werkzeuge/vaiaconversation
claude            # einmal anmelden: /login
./server.py       # öffnet http://127.0.0.1:8797

Oder im Finder start.command doppelklicken. Gespräche liegen danach in gespraeche/ als Markdown, Arbeitsordner der Agenten daneben.

Kurz gesagt

Nicht die erste Antwort. Die geprüfte.

Claude Code erledigt. vaiaconversation lässt erledigen und widersprechen – mit Rollen, Regie, Protokoll und Kosten je Beitrag. Für Entscheidungen, für Code, für alles, wo eine zweite Meinung billiger ist als ein Fehler.